
HR 的 vibe coding:一份实战指南
该自己做什么、该买什么,以及怎样分清两者,同时不泄露你的薪酬数据。
Written by
Joris Luijke, Co-Founder & Co-CEO
变化在哪里:HR 现在可以自己做工具了
一年前,如果你想要一个定制的认可工具,你有两个选择。求工程团队在路线图里挤出位置,或者买一个现成的。今天,你打开 Claude,描述你想要的东西,午饭前就能有一个可用的版本。
问题变了。它不再是你能不能做出来。现在的问题是你该不该做,以及你怎样做决定。
大多数 HR 负责人以为自己面对的是 AI 采用的问题。不是。他们面对的是可见性的问题。你的团队早就把 AI 带进了这个职能。已经有人在把薪酬数据、申诉记录和候选人信息粘贴进没人批准过的消费级聊天机器人,周围没有任何治理。用不用 AI 这个决定,已经有人替你做了。还由你来定的,是你能不能看见它。
做了十来个这样的工具、又和做同样事情的 HR 团队聊过之后,我的结论是这样的。你能用 vibe coding 安全地做到什么程度,限制不在于数据有多敏感。而在于你有没有那份自律,把数据流好好地组织起来。做对了,可以动手的范围比大多数 HR 团队以为的大得多。做错了,你连认可机器人都不该做,更别说任何要紧的东西。
有一条规则仍然贯穿始终:
仪式用 vibe coding 来做。记录系统花钱去买。
这份指南的其余部分是操作手册,包括这条线会移动的那部分。
三个数据层级,以及你可以在哪些层级上动手
我见到的最常见的错误:团队根据工具感觉上有多重要来决定做什么。坐标轴选错了。
这条线是由工具接触的数据划定的,也取决于你准备为此做些什么。
三个层级:
→ 仪式和工作流数据。认可、情绪脉搏调查、提醒、职业框架。敏感度低,波及范围小。放手去做。
→ 敏感但有边界的数据。敬业度调查的原话、1:1 记录、尚未公布的重组草案。完全可以做,前提是你已经决定了数据放在哪里、谁能看到。
→ 记录系统。薪资、薪酬、合同、个人身份信息,任何关系到真实决策的东西。这些去买,或者用正规的工程流程来做。
把这些层级读作对你需要具备什么条件的描述,而不是一堵墙。第一层几乎对你没有要求。第二层要求你想清楚存储和访问。第三层要求的是一整套合规体系,一家公司要花好几年才能建起来,这就是为什么买通常是更明智的选择。
有一家监管机构也划了一条类似的线,这值得你坐直了听。根据欧盟《人工智能法案》,用于雇佣决策(招聘、甄选、绩效评估、晋升、解雇)的 AI 被归为高风险,在人工监督、文档和日志方面负有义务。欧盟委员会自己的指引,几乎恰好沿着“仪式”和“记录”之间的那道缝把这个领域一分为二。打分、排名、筛选或做决定的工具在适用范围内。面试排期、把简历解析进可搜索的数据库、雇主品牌广告这类行政工具,则往往不在其中。
认可不是解雇。这话你已经说了很多年。现在法律也同意了。
一页纸的地图:用 vibe coding 做,还是买
在讲细微差别之前,先看我一再用到的这张地图。
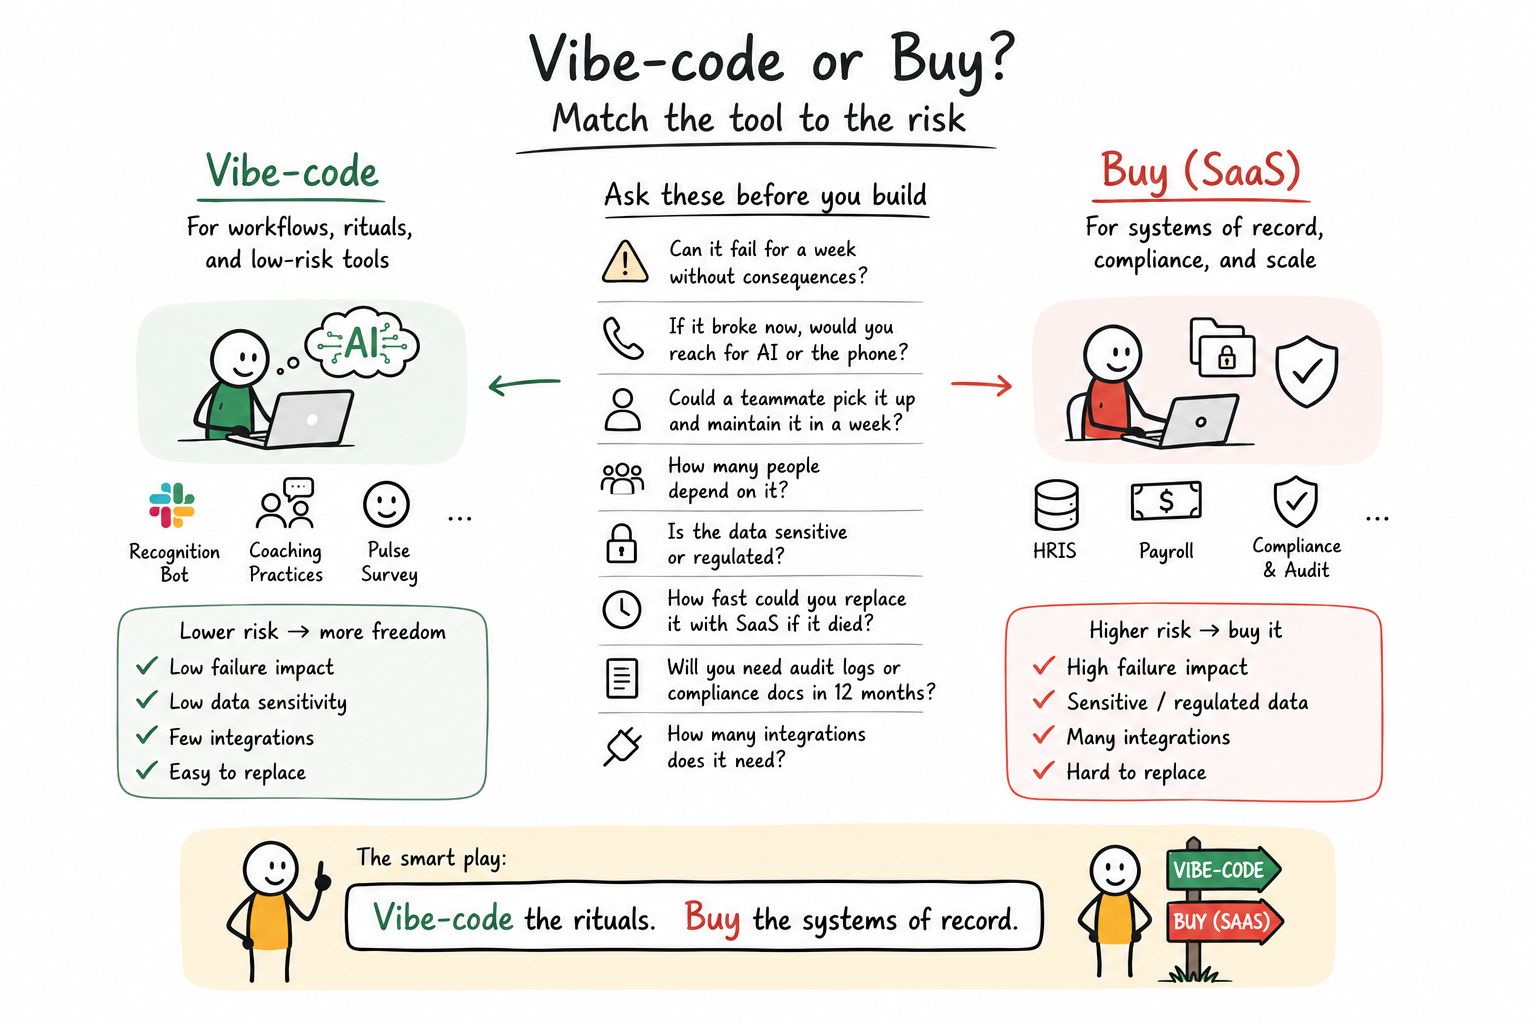
仪式用 vibe coding 来做。记录系统花钱去买。中间的八个问题就是全部的决策。
左边,用 vibe coding 做。认可机器人、辅导练习、脉搏调查。出故障的影响小,数据敏感度低,集成少,容易替换。风险越低,你的自由度越大。
右边,去买。HRIS、薪资、合规和审计。出故障的影响大,数据敏感或受监管,集成多,难以替换。风险更高,就买。
中间的八个问题就是全部的决策。把任何工具的想法过一遍这些问题,答案通常自己就出来了。我最喜欢第二个,因为它能穿透一切:如果它现在就坏了,你会去找 AI,还是去拿电话?
我是在团队上一次做重组时学会相信这一点的。我们用一张 Google Sheet 来跟踪,有 14 个标签页、三种颜色的高亮,还有一份单独的文档解释这些高亮是什么意思。我们有一半人用的是已经过时的版本。阻力大,数据敏感度低,没有哪家供应商做得像样。这是教科书式的适合 vibe coding 的东西,于是我做了 (re)org,从此不再受罪。
四选一:买、包一层、混合,还是自建
那张地图是思维模型。现实更乱,因为大多数 HR 工具并不干干净净地落在某一边。所以,下面是难以决断时我实际使用的版本。
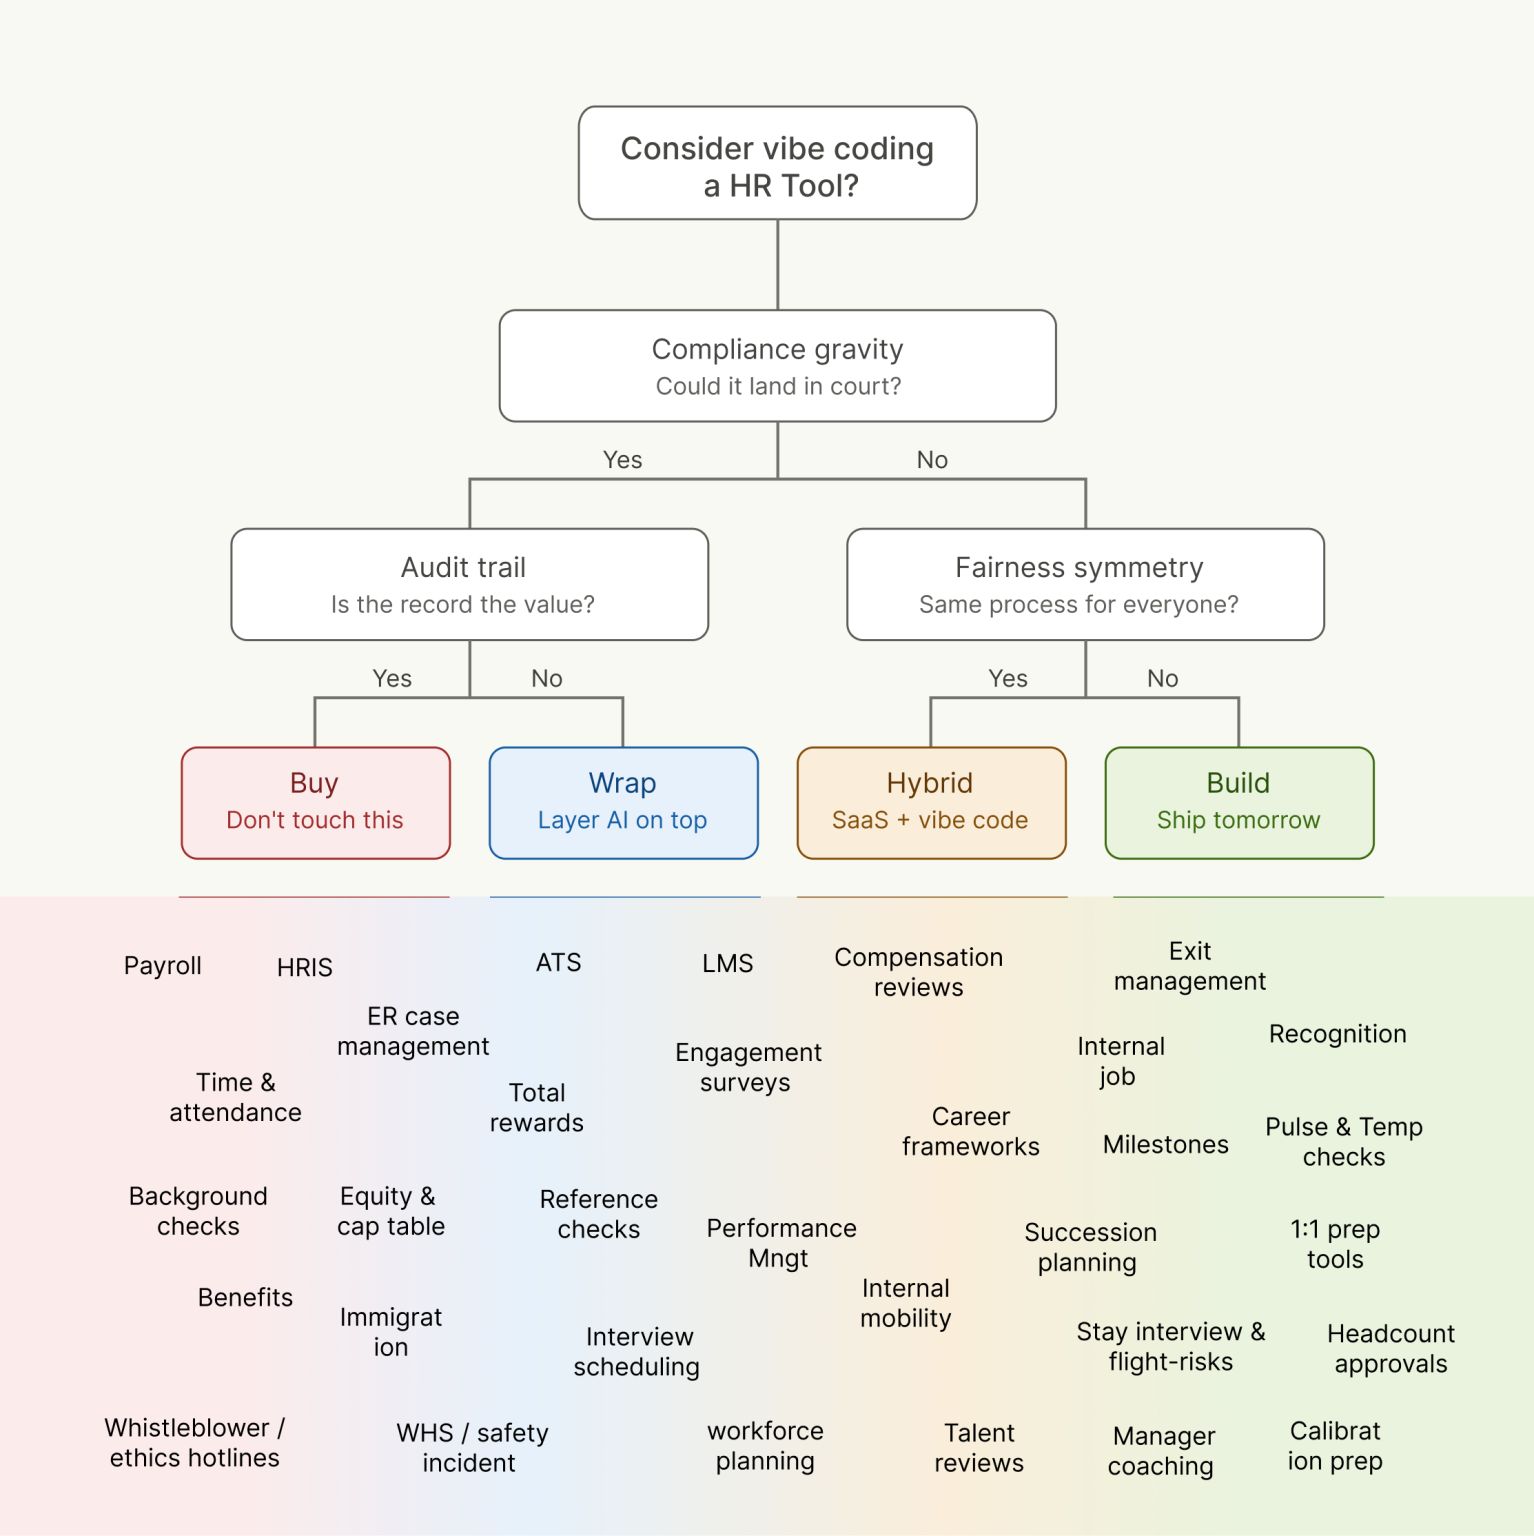
两个问题,四个答案:买(Buy)、包一层(Wrap)、混合(Hybrid),还是自建(Build)。
整件事由两个问题驱动。
第一,合规的分量。这件事有可能闹上法庭吗?
如果有可能,再多问一句。记录本身就是价值所在吗?如果是,你就买。薪资、HRIS、工时和考勤、背景调查、福利、举报和道德热线。这些工具的价值在于,记录完整、经得起质疑,而且责任在别人身上。在这里,买不是胆小。而是拒绝背上一份你从拥有它当中什么也得不到的责任。
如果合规的分量是实打实的,但记录并不是全部的意义所在,你就包一层。在一个承担着底层风险的系统之上,叠加你自己的 AI。员工关系案件管理、整体薪酬、股权和股权结构表、移民事务、安全事故、ATS、背景核实。你得到了想要的工作流,又不用拥有危险的那部分。“包一层”是大多数团队低估自己的地方。这个格子里可以动手做的东西很多。
如果不可能闹上法庭,就换一个问题。这个流程对每个人都一样吗?
这个问题最容易被忽视,而且非常 HR。公平的对称性。当一个工具对每个人运行同样的流程时,风险保持在低位。一旦它开始区别对待不同的人,决定谁得到什么,你就走进了偏见和可辩护性的地带,风险陡然升高。
流程对每个人都一样,你就走混合。SaaS 加 vibe coding。薪酬评估、敬业度调查、职业框架、绩效管理、内部流动、继任规划、人才盘点。把记录留在你信任的系统里,围绕它自己搭建仪式和体验。
在设计上就因人而异、合规分量又低,你就自建。明天就上线。认可、脉搏和温度检查、1:1 准备工具、里程碑、经理辅导、留任面谈、离职管理。这是 vibe coding 的腹地。
注意“自建”在这里的含义。不是重要或不重要。它的意思是合规分量低,而且流程对每个人一视同仁。这个安全区比大多数 HR 团队以为的大,而且四个格子里有三个都需要你动手做点什么。
让你能用敏感数据做工具的六种做法
我发帖聊过其中一部分,Aubrey Blanche 问了我在这个话题上遇到的最尖锐的问题。大意是:你是不是只对技术栈里不含敏感数据的部分用 vibe coding,你又是怎样处理 HR 每天经手的那类个人数据所带来的伦理和法律要求的?
问得在理,也值得好好回答,因为它暴露了大多数这方面的指南搞错的地方。它们把敏感数据当作一道硬边界。其实它是一项做法上的要求。把这件事做好的团队,并不比别人更大胆。他们把数据流组织好了,让风险从一开始就不会累积。
下面是我从已经在明智地做这件事的公司那里看到的:
→ 没有人重新发明合规。数据放在一个已经通过审查的数据库之上。Pyn、Supabase、Airtable Enterprise、你现有的数据仓库。你继承的是它的合规状况,而不是为敏感数据另起炉灶搭一套基础设施。这是最重要的一条,而且遥遥领先。大多数恐怖故事,都是从有人自己搭存储开始的。
→ 毫不留情的数据最小化。只收集工具实际需要的东西。大多数 HR 工具做出来时会收集一切能拿到的东西,只因为它就在那儿。一个情绪工具需要的是一个分数和一个团队,而不是姓名和汇报链。
→ 对员工真正透明。他们告诉大家收集了什么、为什么收集、放在哪里。这件事做好了,胜过普通的 SaaS 应用,后者的 DPA 从来没人读过。
→ 法务和 IT 一开始就参与,而不是到最后。大多数公司已经有一份这方面的清单。把它拿来,直接放进你的 CLAUDE.md,这样它从第一条提示词起就引导每一次构建,而不是在最后以否决的形式出现。
→ 默认设置保留期限。情绪数据一个季度后自动删除。你不再持有的数据,就是你泄露不了的数据。
→ 个人身份信息不经过 LLM API。这才是真正的红线,它比“让敏感数据远离 AI”窄得多。
做到这六件事,你能做的东西就比这类建议的谨慎版本所暗示的多得多。跳过它们,你就应该老老实实用 SaaS。
Vibe coding 不等于鲁莽行事。自律是入场的门票,而这张门票比大多数 HR 团队以为的便宜得多。
实战案例:做出并上线一个绩效评估工具
理论很容易。假设你想做点更有挑战的东西:就拿绩效评估工具来说吧,因为这是我听到最多的需求,而且它正好处在那条有意思的边界上。
首先,老老实实地划定范围。
评估工具属于“混合”(见测评)。流程对每个人都一样,这压低了风险,但合规的分量是实打实的,因为评级会影响薪酬决定和解雇,也会被卷进纠纷。所以,在写提示词之前,先决定你的工具可以拥有什么。评估周期、提醒、经理的准备材料、草稿笔记、完成情况跟踪,这些你可以做。但最终评级、校准结果,以及任何在解雇某人时会被引用的东西,你仍然需要一份审计记录。(如果这个系统是薪酬/绩效决定的记录,它就在法律取证的范围内)
然后,你需要给它找个安身之处。
下面是我用的技术栈。注意:其中每一样都有不错的替代品。Cursor 可以替代 Claude Code,Neon 或 Airtable 可以替代 Supabase,Vercel 或 Render 可以替代 Railway,GitLab 可以替代 GitHub。我不是说这些是客观上正确的选择。它们是我用来做过东西的,彼此配合得好,而且在你学习的阶段很宽容。任何一样都可以换成你已经熟悉的东西。
这些工具,以及每一样为什么在这里
✍️ Claude Code 负责把它做出来。不是聊天窗口。这个版本能在你的整个项目里工作、运行命令,并遵守你在一个叫 CLAUDE.md 的文件里写下一次的规则,这样你的数据分类和法律护栏就适用于每一条提示词,而不只是你记得的那些。(用你现有的订阅。)
↳ 要注意:CLAUDE.md 是指引,不是强制。模型可以无视它,而且没有审计记录能证明它没有无视。
🗄️ SUPABASE 是数据存放的地方。把它想成文件柜,再加一把锁。它负责登录,而这类代码你绝不该让 AI 即兴发挥。它还在数据库层面强制执行“谁能看到什么”,所以“经理只能看到自己团队的评估”是数据库自己守住的规则,而不是一条你的应用得在每一处取数据的地方都记对的规则。对员工数据来说,这个区别就是全部的关键。(每月 25 美元。599 美元那一档见下面的说明。)
↳ 要注意:行级安全默认是关闭的。只要有一张表没保护,每个人就能读到每个人的评估。策略还需要按角色逐一测试,而几乎没人测试反面的情形,偏偏那些才是要紧的。
🪪 GOOGLE LOGIN 证明一个人是谁。如果你们用 Google Workspace,你已经有了一个知道每个人姓名、经理和部门的目录。把它接进来,就没有人需要再设一个密码,而且当 IT 在某人最后一天停用其账号时,对方也自动失去了对你这个工具的访问权。(免费,包含在 Workspace 里。)
↳ 要注意:你必须把它限制在你们的 Workspace 域名内。不限制的话,地球上任何一个 Google 账号都能登录。
⏰ RAILWAY 负责运行它。让应用在互联网上真正有个安身之处,更重要的是,有个地方按计划运行任务。周期周一开启,提醒周四发出,一周后再催那些拖拉的人。大多数 HR 仪式都是定时的工作,所以这一点很重要。(每月约 5 到 20 美元。)
↳ 要注意:定时任务可能重复触发或被跳过,而你毫无察觉。
↩️ GITHUB 是你的撤销键。工具的每个版本都会被保存,所以当 AI 信心满满地把昨天还好好的东西弄坏时,你可以退回去。没得商量,而且免费。(免费。)
↳ 要注意:只有当你的提交干净又频繁时,它才是撤销键。而且回滚代码并不会撤销数据库迁移,也不会把删掉的数据带回来。
💬 SLACK (TEAMS) 是大家实际使用它的方式。如果员工得记得还有个门户网站存在,使用率就死了。提醒必须出现在他们本来就在的地方。(在你自己的工作区里构建是免费的。)
↳ 要注意:机器人发来的关于绩效的私信,读起来像监控。而且通知疲劳照样会毁掉这个仪式,所以要精打细算地使用提醒。
🚨 SENTRY 在它出故障时告诉你。没有它,你会从员工那里得知,这对一个 HR 工具来说是本末倒置。(免费档就够用。)
↳ 要注意:错误信息默认会带上个人身份信息和评估文本。在它接触真实数据之前,你需要配置好脱敏,并签好 DPA。
✉️ RESEND 负责发邮件,用在 Slack 不够的时候。如果你只通过 Slack 提醒,可以不用。(每月 3,000 封邮件以内免费。)
↳ 要注意:需要在你的域名上设置好 SPF、DKIM 和 DMARC。跳过这一步,你的邮件会进垃圾箱,或者你会被标记为在仿冒自己的公司:
🔑 ANTHROPIC API KEY,只在工具自身在运行时调用 AI 的情况下才需要,比如总结经理的笔记。值得知道的是,它与你的 Claude 订阅是分开计费的,订阅覆盖的是你写代码,而不是你的应用发起调用。不少团队上线之后才在这里栽跟头。(每月 5 到 50 美元,视用量而定。)
↳ 要注意:没有支出上限,就意味着可能收到一张意外的账单。一个循环就能很快把额度烧光。
🌐 域名给它一个让人信任的地址。放在公司网站正规子域名上的内部工具会有人用。同一个工具放在一串随机字符上,就会被忽略,或者更糟,被当作钓鱼企图举报。(每年约 15 美元,或者用你已有的子域名则免费。)
↳ 要注意:需要 IT 和 DNS 的控制权。
🔍 一次技术审查 这显然不是工具。但除非你们内部有这个能力,否则要留出预算,请一位懂技术的人在真实的员工数据靠近它之前,检查访问规则和登录流程。不是让对方来做。是来检查。(外包人员半天的时间,一次性 500 到 1,500 美元。)
↳ 要注意:一次性的审查,在下一次 AI 生成的改动之后就过时了。
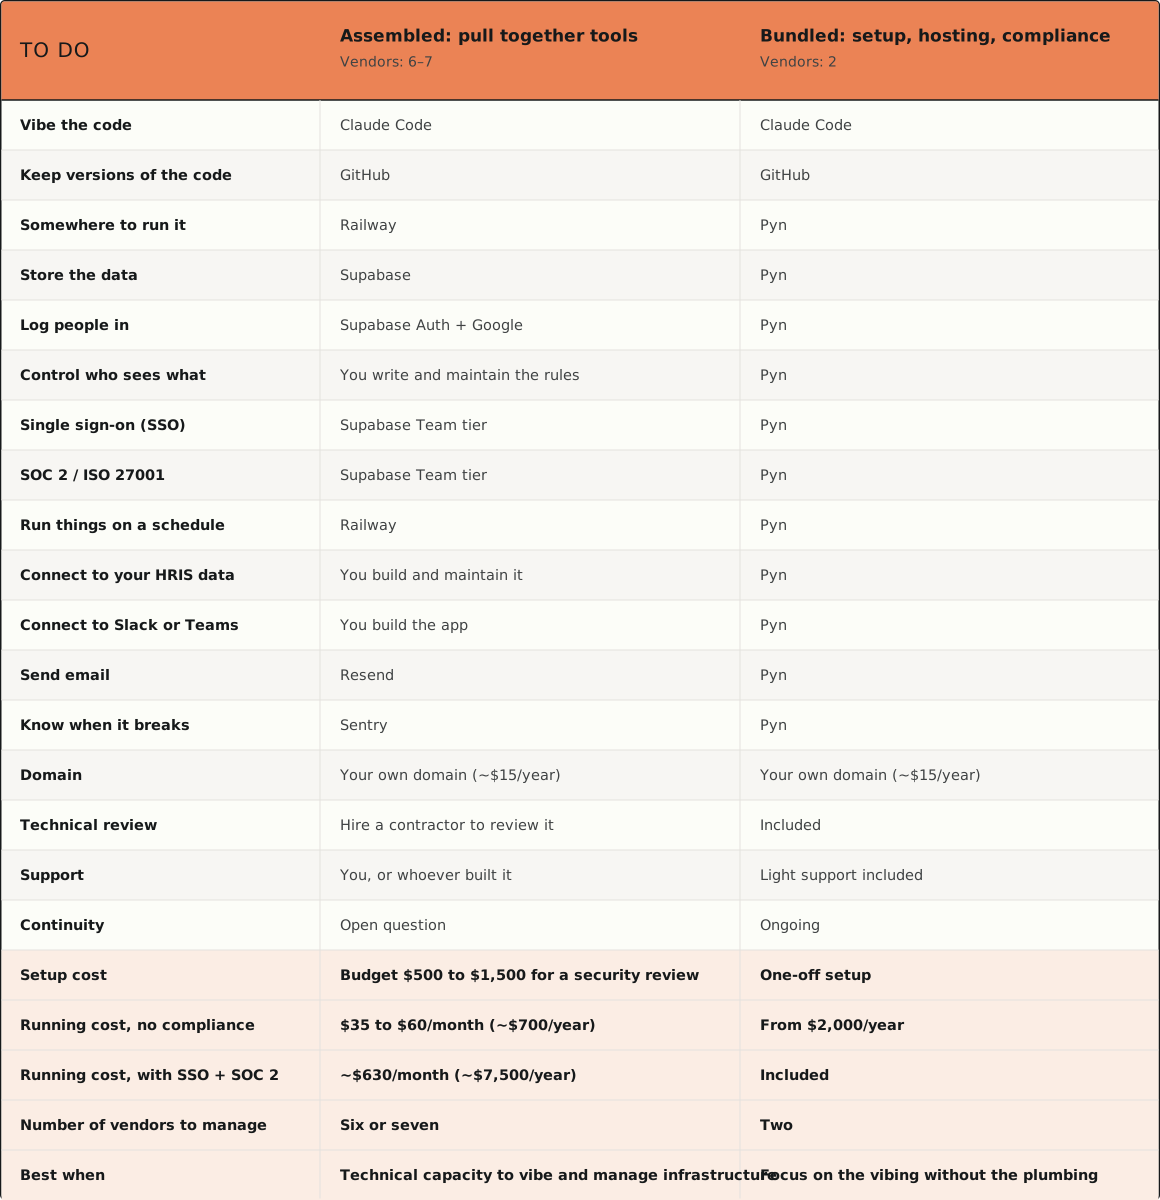
工具全算上,每月大约 35 到 60 美元,如果你需要单点登录和 SOC 2,最高到 660 美元。另加一次性的技术审查,500 到 1,500 美元不等。预算里没有算进去的,是与持续维护、值班相关的任何成本,以及做工具的人离开之后由谁负责。
📦 或者用 PYN,如果你不想自己组装的话。如果你想要打包得更完整的方案,Pyn 可以替代 Supabase、Google 登录、Railway、Resend、Slack 或 Teams 应用和 Sentry,并替你打理它们。设置、测试和轻量支持都包含在内,还有单点登录和 SOC 2。工具仍然由你来写。(成本详见下文。)
25 美元和 599 美元的问题
Supabase 有 25 美元的一档和 599 美元的一档,两者之间的差距是这整一节里最重要的数字。25 美元,你得到数据库、登录和逐行的访问控制。这足以从容地覆盖仪式类工具和大多数“敏感但有边界”的工具。
599 美元,你得到单点登录、SOC 2 鉴证、ISO 27001、审计日志和更长的备份保留期。当你们自己的安全团队要求提供证据、工具里存着真正敏感的员工数据,或者一句承诺已经不够、有人要看证书时,你需要的就是这一档。和 25 美元放在一起,它听起来很多。但它只是自己建立这种合规状况所需成本的一个零头,也比大多数 HR SaaS 便宜得多。
不过说实话,SOC2 这类东西还带来大量这里没有列出的工作。升级主要是让工具更稳健。要真正合规,就让 Pyn 来托管。
触发条件很简单。法务或 IT 的某个人一问“这个符合 SOC 2 吗”,你就该在 599 美元那一档上了,而且早就该在了。
打包的方式:专注于 vibe coding,不用管管道
上面的一切都假定你想自己拥有这些管道。很多团队并不想。
另一种做法是把这些工具托管在 Pyn 上。东西仍然由你用 vibe coding 来做,它仍然是你的工具,但 Pyn 处理那些你宁愿不去学的部分:登录和访问控制、数据库、设置、与你的 HRIS 和 Slack 的连接、单点登录、SOC 2、上线前的测试,以及在不凑巧的时候出故障时的轻量支持。设置费 9,000 美元,之后每年 2,000 美元。
值不值,归结为一个问题。你有没有这样一个人,能负责认证、访问策略、正常运行时间和集成,并且十八个月之后还在?如果有,就自己组装,更便宜,你也会学到更多。如果那个人其实是“谁有空谁来”,那么问题就会出在维护上,花钱请人把这件事扛起来是更好的选择。
并排对比
同一个工具,同样的代码,两种上线方式。左栏是你自己组装一切。右栏是你仍然自己做,但管道有人打理。
上线一个内部 HR 工具需要什么
构建时 vs 运行时:员工数据到底什么时候有风险
这一节能化解我听到最多的那个反对意见。“我们不能用 AI 来做工具,我们不能把员工数据发给它。”
你把两个不同的决定混在一起了。
构建时。做工具的时候,你发给模型的是代码,不是员工记录。你用合成数据来开发。用云端没问题。没有任何敏感的东西会靠近 AI。
运行时。数据的问题是后来才出现的,也就是一个上线的智能体为了完成工作,开始读取真实的员工记录的时候。数据驻留、本地部署的模型和访问控制,是在这里才真正要紧。
我是在做一个离职自动化的演示时学会划这条线的。我用合成的 BambooHR 数据来跑它,不是因为构建它有风险,而是因为真正的约束在于一个上线的智能体读取真实的记录。构建和运行是两个不同的房间。别让构建时的恐惧把你吓得止步不前,也别因为对自己说了一句“只是 AI 在写代码而已”,就让运行时的风险溜过去。
干净利落的说法是:“用 AI 来做这个安全吗”,答案几乎总是肯定的。“放手让这个东西接触真实数据安全吗”,才是值得你关注的问题,而只要你做了上面那六件事,它就有一个好答案。
成本:什么时候该用普通的自动化,而不是 AI
AI 确实很棒。它也是概率性的,每次运行都不便宜,而且难以观测。所以这里的自律很无聊。先用普通的自动化尽可能多地解决问题,把 AI 留给真正需要判断或语言能力的部分。
基于规则的工作流,也就是 Zapier、n8n 或 Pyn 那种不性感的东西,便宜、可预测、容易调试。它坏的时候,每次都以同样的方式坏。AI 智能体一样都不占。它每触发一次都要花更多钱,周二做的事可能和周一略有不同,而要弄清原因得真下一番功夫。
让我印象深刻的一个数字:据报道,Uber 大约四个月就烧光了全年的 AI 预算。概率性的工具,就是有本事趁你看向别处的时候把账单越滚越大。
所以成本的问题不是“用不用 AI”。而是“能完成这项工作的最简单的机制是什么”。如果一个自动化就能发提醒、流转请求或更新字段,就用它。把昂贵、不可预测、重判断的工具,留给它物有所值的地方。自动化无聊又便宜。这正是你首先该用它的原因。
可见性:有好几个工具在跑之后,该跟踪什么
这个陷阱很简单。你用 vibe coding 做了一个工具。然后是五个。然后有三十个自动化在你的组织里触发,而你已经理不清头绪了。你看不到什么在运行、触达了谁,也看不到其中有没有哪个真的有效。
恭喜。你重建了影子 IT。只不过现在上面印着你的 logo。
解决办法是从一开始就把“能看见”做进去。每个工具都应该呈现三件事:
→ 谁在经历什么。哪些员工和经理实际收到、看到并使用了这个东西。
→ 什么在触发。哪些 AI 调用和自动化在运行,什么时候、多久一次。
→ 结果。不是虚荣指标。是完成情况、阅读情况和未落实情况,也就是谁本该做这件事却没做。
最后一项是被忽视的杀手级功能。大多数 HR 工具能告诉你发生了什么。很少能告诉你谁没有做自己被要求做的事。随着 HR 领域的 AI 有了更多的文档和日志,能回答这个问题,会很快从一个好看的仪表盘,变成一份你庆幸自己留下了的审计记录。
在上线一个工具之前,先决定你要怎样看着它工作。如果你回答不了“谁经历了这个、发生了什么”,你就还没做完。
集成:把数据从一个工具送到下一个工具
一个把数据囤在自己手里、用 vibe coding 做出的工具不是资产。它是一座孤岛,而孤岛是价值的葬身之地。
情绪分数、认可信号、重组决定、完成数据。其中大部分只有流动起来才有价值:流进下一个工具,流进经理的工作情境,并流进它该去的地方,也就是记录系统。一个从不告诉你的人才流程“是谁在把团队凝聚在一起”的认可工具,只是个好玩的玩具。把这个信号接进绩效和继任,它就成了杠杆。
所以,从第一天起就给每个工具设计一条出口。一个导出功能、一个 API、一个 webhook。有意识地决定什么流向哪里。什么同步回记录系统。什么留在本地、永不离开浏览器。什么喂给下一个仪式。
真正的大奖就在这里。你不是靠拥有薪资系统来取胜的。已经有人拥有它了,而你也不该想要。你取胜靠的是拥有横跨一切的情境层,那层知道谁在经历什么的结缔组织,让你做的每一个工具都因为其他工具的存在而变得更聪明。
仪式用 vibe coding 来做,记录系统花钱去买,然后拥有上面的那一层。
维护:哪些你可以自己修,哪些不行
对一家较小的企业来说,每月 500 美元的 SaaS 工具感觉很贵。一个周末的 Claude 提示词感觉是免费的。两者都不对。
构建只占工作的 20%。维护是另外的 80%。托管、认证、日志、审计记录,还有那些在供应商不打招呼就改了 API 时坏掉的集成。没有一样是光鲜的。每一样都是必需的。
好消息是,这里可以真正换个角度看。这些维护工作,现在大部分都可以用 vibe coding 的方式来做。HR 团队把整件事的代价估得过高,因为他们想象的是像维护脆弱的企业软件那样去维护它,金贵得碰都不敢碰。通常并非如此。你可以用当初做出这些工具的方式,去修复、调整和扩展它们。别对代码怕到不敢改它。
真正的制衡在于:有些东西你没法用 vibe coding 来维护。认证、个人身份信息的处理、真正的集成、审计日志。工具一旦跨进这个地带,“我提示一下修掉就行”就不够了。知道自己处在哪一类才是真本事,而继承数据库的合规状况,在这副担子落下来之前就替你卸掉了大半。
还有,要早点问那个不光鲜的问题。Sarah 走了之后,这个东西归谁管?一个只活在某一个人脑子里的工具是一处脆弱点,而不是一项成就。
安全:每类工具需要多严格
那个吓人的数字是真的。一家安全公司扫描了数千个已部署的、用 vibe coding 做出的应用,发现大约三分之一在上线时带有严重的、可被利用的漏洞。一项又一项研究发现,AI 生成的代码带有的安全缺陷明显多于人写的代码。泄露的密钥、注入漏洞、失效的访问控制。
别把这读成停止动手的理由。把它读成波及范围。认可墙里的 SQL 注入漏洞,泄露的是点赞。薪酬工具里一模一样的漏洞,泄露的是工资。同样的缺陷,后果完全不同。让你的严格程度与数据层级相匹配,这就是为什么你要先给数据分类,也是为什么继承一个经过审查的数据库如此重要。那三分之一的失败里,有相当一部分出在做工具的人本来就不该自己去搭的基础设施上。
有两件事值得刻在脑子里:
“能用”和“安全”感觉一模一样,其实不是一回事。 AI 生成的代码可以看起来完全正确,却藏着一个严重的漏洞。它能运行,所以看起来没问题,而这个漏洞一直隐形,直到有东西坏掉。对不懂技术的构建者来说,这就是全部的陷阱。
纯客户端是一种实实在在的隐私立场,也有实实在在的局限。 我的好几个工具都是纯客户端应用。没有后端,没有任何东西离开你的浏览器,所以不会有一堆员工数据躺在服务器上。就传输中的数据和第三方风险而言,确实比典型的 SaaS 更安全。但这是个人草稿本的立场,而不是记录系统的立场。浏览器存储没有静态加密,没有访问控制,没有审计日志。用来模拟一次重组再合适不过。但不是你存放任何丢不起的东西的地方。
当一个工具凭实力升到更高的数据层级时,别凭感觉硬来。请一位技术伙伴,一位兼职 CTO 或一家开发工作室,来审查哪些部分是承重的、哪些是脆弱的。然后有意识地让它毕业,从纯客户端升级到托管在真正的基础设施上,带有像样的认证、多租户、加密、审计日志和基于角色的访问控制。这就是一个周末项目和一个上千人可以安全使用的东西之间的区别。
动手之前要问的八个问题
当你不想走完整棵决策树时,就把工具过一遍这八个问题。它们就是第一张地图里的那些问题,按我实际提问的顺序排列:
- 它能不能坏上一周而没有后果?
- 如果它现在坏了,你会去找 AI,还是去拿电话?
- 一位同事能不能在一周内接手并维护它?
- 有多少人依赖它?
- 数据是否敏感或受监管,如果是,它放在谁的基础设施上?
- 如果它挂了,你多快能用 SaaS 替换它?
- 12 个月后你会需要审计日志或合规文档吗?
- 它需要多少个集成?
第五个问题是最会让答案移动的一个。敏感数据放在你自己搭的基础设施上,是停下来的理由。同样的数据放在一个已经具备合规状况的数据库里,是继续往前的理由。
我做的五个免费工具,供你找灵感
理论说够了。下面是我在过去几周里用 vibe coding 做的五个工具。每一个都是仪式。没有一个是记录系统。这不是巧合。这正是全部的要点。
你想怎么用都行。当作灵感,直接照抄,或者如果你宁愿省下那个周末,直接用就是了。它们是免费的。
🔄 (re)org → 组织架构图和重组情景模拟。把人拖来拖去,标出离职和未分配的岗位,并排比较不同的情景,实时看薪酬差额的变化。完全在客户端运行,所以没有任何东西离开你的浏览器。对一份敏感的重组草案来说,这是合适的立场。
🦘 Dollaroo → 同事间认可。让点赞出现在工作发生的地方,也就是 Slack 里。这是那种风险低、温度高的仪式,没有供应商做得好,而人人都想要。(真正的大奖在下游。把这个认可信号接进你对人才和继任的思考,你就能知道是谁在把团队凝聚在一起。)
🌡️ Team Temperature → 每周情绪。点一下就能了解团队的实际状态。投票不是重点。可见性才是:一个持续的信号,告诉你谁在经历什么,赶在它出现在离职面谈里之前。
📉 Drift → 季度绩效检查。是的,“绩效”听起来应该归在“买”那一栏。但 Drift 不是决定评级或薪酬的系统。它是负责“留意”的仪式。人很少会一下子掉下悬崖。他们是一个季度一个季度地漂移。完整的评估周期把注意力平均分给每个人,包括那些本来就没问题的人。Drift 把焦点放在真正影响团队绩效的少数几个个案上,这样你能在任何人感到意外之前就留意到。是仪式,不是记录。
🌱 Grow → 职业成长框架。不用请顾问、也不用买六位数的平台,就能有职业框架。它也是构建时和运行时那条线最清楚的例证。Grow 是一个纯客户端应用,所以员工数据从不离开浏览器。AI 帮我把它做了出来。它从来看不到你的员工。
五个工具,一个模式。范围窄、面向内部的仪式,每一个都被设计成把数据往下传,而不是囤起来,每一个都放在已经具备合规状况的基础设施上。正是最后这一点,让做出它们只花了一个周末,而不是一个项目。
接下来的方向:情境层
把这件事做对的团队,并不把自己的代码看得金贵。他们看得金贵的是数据流,以及员工的信息最后去了哪里。
这是值得带走的一点。HR 能做多少东西,约束不在于你持有的数据有多敏感。而在于你有没有做那六件不光鲜的、阻止风险累积的事。继承合规状况,而不是自己建。少收集。告诉大家你在收集什么。从第一条提示词起就让法务和 IT 参与。按计划删除。让个人身份信息远离 LLM API。
做到这些,然后仪式用 vibe coding 来做,记录系统花钱去买,再在上面搭建情境层,让所有这些加起来的价值大于各部分之和。
大多数 HR 团队在这件事上,比他们需要的保守得多。
你会把线划在哪里?