
Vibe coding voor HR: een veldgids
Wat je bouwt, wat je koopt en hoe je het verschil ziet zonder je salarisdata te lekken.
Written by
Joris Luijke, Co-Founder & Co-CEO
Doe onze test "Should HR Vibe This?"
Tien korte vragen. Een eerlijk antwoord op de vraag of je het bouwt of eromheen bouwt.
Wat er is veranderd: HR kan nu zijn eigen tools bouwen
Een jaar geleden had je twee opties als je een eigen tool voor erkenning wilde. Bij engineering smeken om ruimte op de roadmap, of iets kant-en-klaars kopen. Vandaag open je Claude, beschrijf je wat je wilt en heb je vóór de lunch een werkende versie.
De vraag verandert. Het gaat er niet meer om of je het kunt bouwen. Het gaat erom of je het moet doen, en hoe je dat beslist.
De meeste HR-leiders denken dat ze een probleem hebben met de invoering van AI. Dat hebben ze niet. Ze hebben een probleem met zicht. Je team heeft AI al binnengehaald. Iemand plakt nu al salarisdata, aantekeningen over klachten en gegevens van kandidaten in een consumentenchatbot die niemand heeft goedgekeurd, zonder enige governance eromheen. De beslissing om AI te gebruiken is voor je genomen. Wat nog aan jou is: of je het kunt zien.
Hier ben ik op uitgekomen, na er zelf een stuk of twaalf te hebben gebouwd en te hebben gepraat met HR-teams die hetzelfde doen. De grens van wat je veilig kunt vibe-coden is niet de gevoeligheid van je data. Het is of je de discipline hebt om je datastromen goed in te richten. Doe je dat goed, dan is het gebied waarin je kunt bouwen veel groter dan de meeste HR-teams denken. Doe je het fout, dan zou je nog geen bot voor erkenning moeten bouwen, laat staan iets wat ertoe doet.
Eén regel loopt er nog steeds doorheen:
Vibe-code de rituelen. Koop de bronsystemen.
De rest van deze gids is de handleiding, inclusief het deel waar de grens verschuift.
De drie datalagen, en op welke je kunt bouwen
De fout die ik het vaakst zie: teams bepalen wat ze bouwen op basis van hoe belangrijk de tool voelt. De verkeerde as.
De grens wordt getrokken door de data die de tool raakt, en door wat je bereid bent daaraan te doen.
Drie lagen:
→ Data over rituelen en workflows. Erkenning, sentimentpeilingen, seintjes, herinneringen, loopbaanraamwerken. Weinig gevoelig, kleine impact als het misgaat. Bouw er maar op los.
→ Gevoelig, maar afgebakend. Open antwoorden uit engagement-enquêtes, aantekeningen van 1:1's, het concept van een reorganisatie voordat die is aangekondigd. Goed te bouwen, zodra je hebt besloten waar de data staat en wie erbij kan.
→ Bronsystemen. Salarisadministratie, beloning, contracten, persoonsgegevens, alles waar een echte beslissing aan hangt. Die koop je, of je bouwt ze met een volwaardig engineeringproces.
Lees die lagen als een beschrijving van wat je op orde moet hebben, niet als een muur. Laag één vraagt bijna niets van je. Laag twee vraagt dat je nadenkt over opslag en toegang. Laag drie vraagt om een compliance-apparaat waar een bedrijf jaren over doet, en daarom is kopen meestal de slimme ruil.
Een toezichthouder heeft een vergelijkbare grens getrokken, en dat is iets om bij stil te staan. Onder de AI-verordening van de EU is AI die wordt gebruikt bij beslissingen over werk (werving, selectie, beoordeling, promotie, ontslag) geclassificeerd als hoog risico, met verplichtingen rond menselijk toezicht, documentatie en logging. De toelichting van de Commissie zelf verdeelt het veld bijna precies langs de naad tussen rituelen en bronsystemen. Tools die scoren, rangschikken, een shortlist maken of beslissen, vallen eronder. Administratieve tools zoals het plannen van sollicitatiegesprekken, het inlezen van cv's in een doorzoekbare database of advertenties voor het werkgeversmerk vallen er meestal buiten.
Erkenning is geen ontslag. Dat zeg je al jaren. Nu is de wet het met je eens.
De kaart op één pagina: vibe-coden of kopen
Vóór de nuance: de kaart waar ik steeds op terugkom.
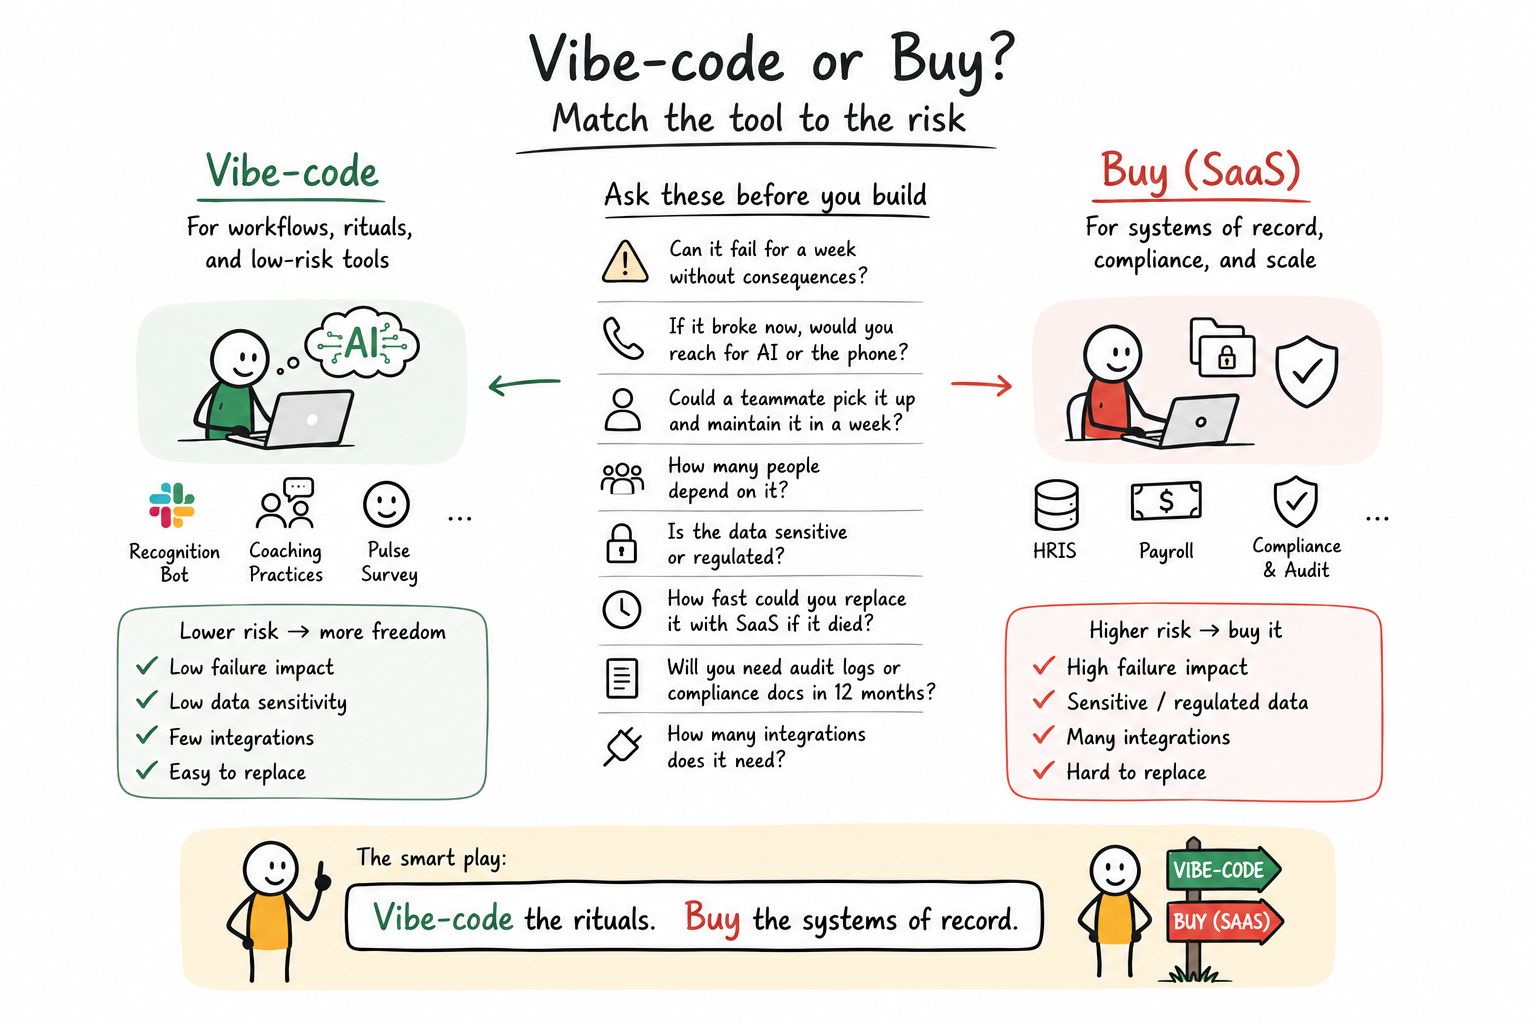
Vibe-code de rituelen. Koop de bronsystemen. De acht vragen in het midden zijn de hele beslissing.
Links vibe-code je. Bots voor erkenning, coachingoefeningen, pulse-enquêtes. Weinig impact als het uitvalt, weinig gevoelige data, weinig integraties, makkelijk te vervangen. Minder risico geeft je meer vrijheid.
Rechts koop je. HRIS, salarisadministratie, compliance en audit. Veel impact als het uitvalt, gevoelige of gereguleerde data, veel integraties, moeilijk te vervangen. Meer risico, dus kopen.
De acht vragen in het midden zijn de hele beslissing. Haal elk idee voor een tool erdoorheen, en het antwoord rolt er meestal vanzelf uit. Mijn favoriet is de tweede, omdat die overal doorheen snijdt: als dit nu stukging, zou je dan naar AI grijpen, of naar de telefoon?
Ik heb hierop leren vertrouwen bij de laatste reorganisatie van mijn team. We hielden die bij in een Google Sheet met 14 tabbladen, drie kleuren markering en een apart document dat uitlegde wat de markering betekende. De helft van ons werkte in een versie die al was verouderd. Veel wrijving, weinig gevoelige data, geen leverancier die het goed doet. Een schoolvoorbeeld van iets om te vibe-coden, dus bouwde ik (re)org en was ik van het gedoe af.
De keuze uit vier: Buy, Wrap, Hybrid of Build
Die kaart is het denkmodel. De praktijk is rommeliger, omdat de meeste HR-tools niet netjes aan één kant staan. Dit is dus de versie die ik echt gebruik als de keuze lastig is.
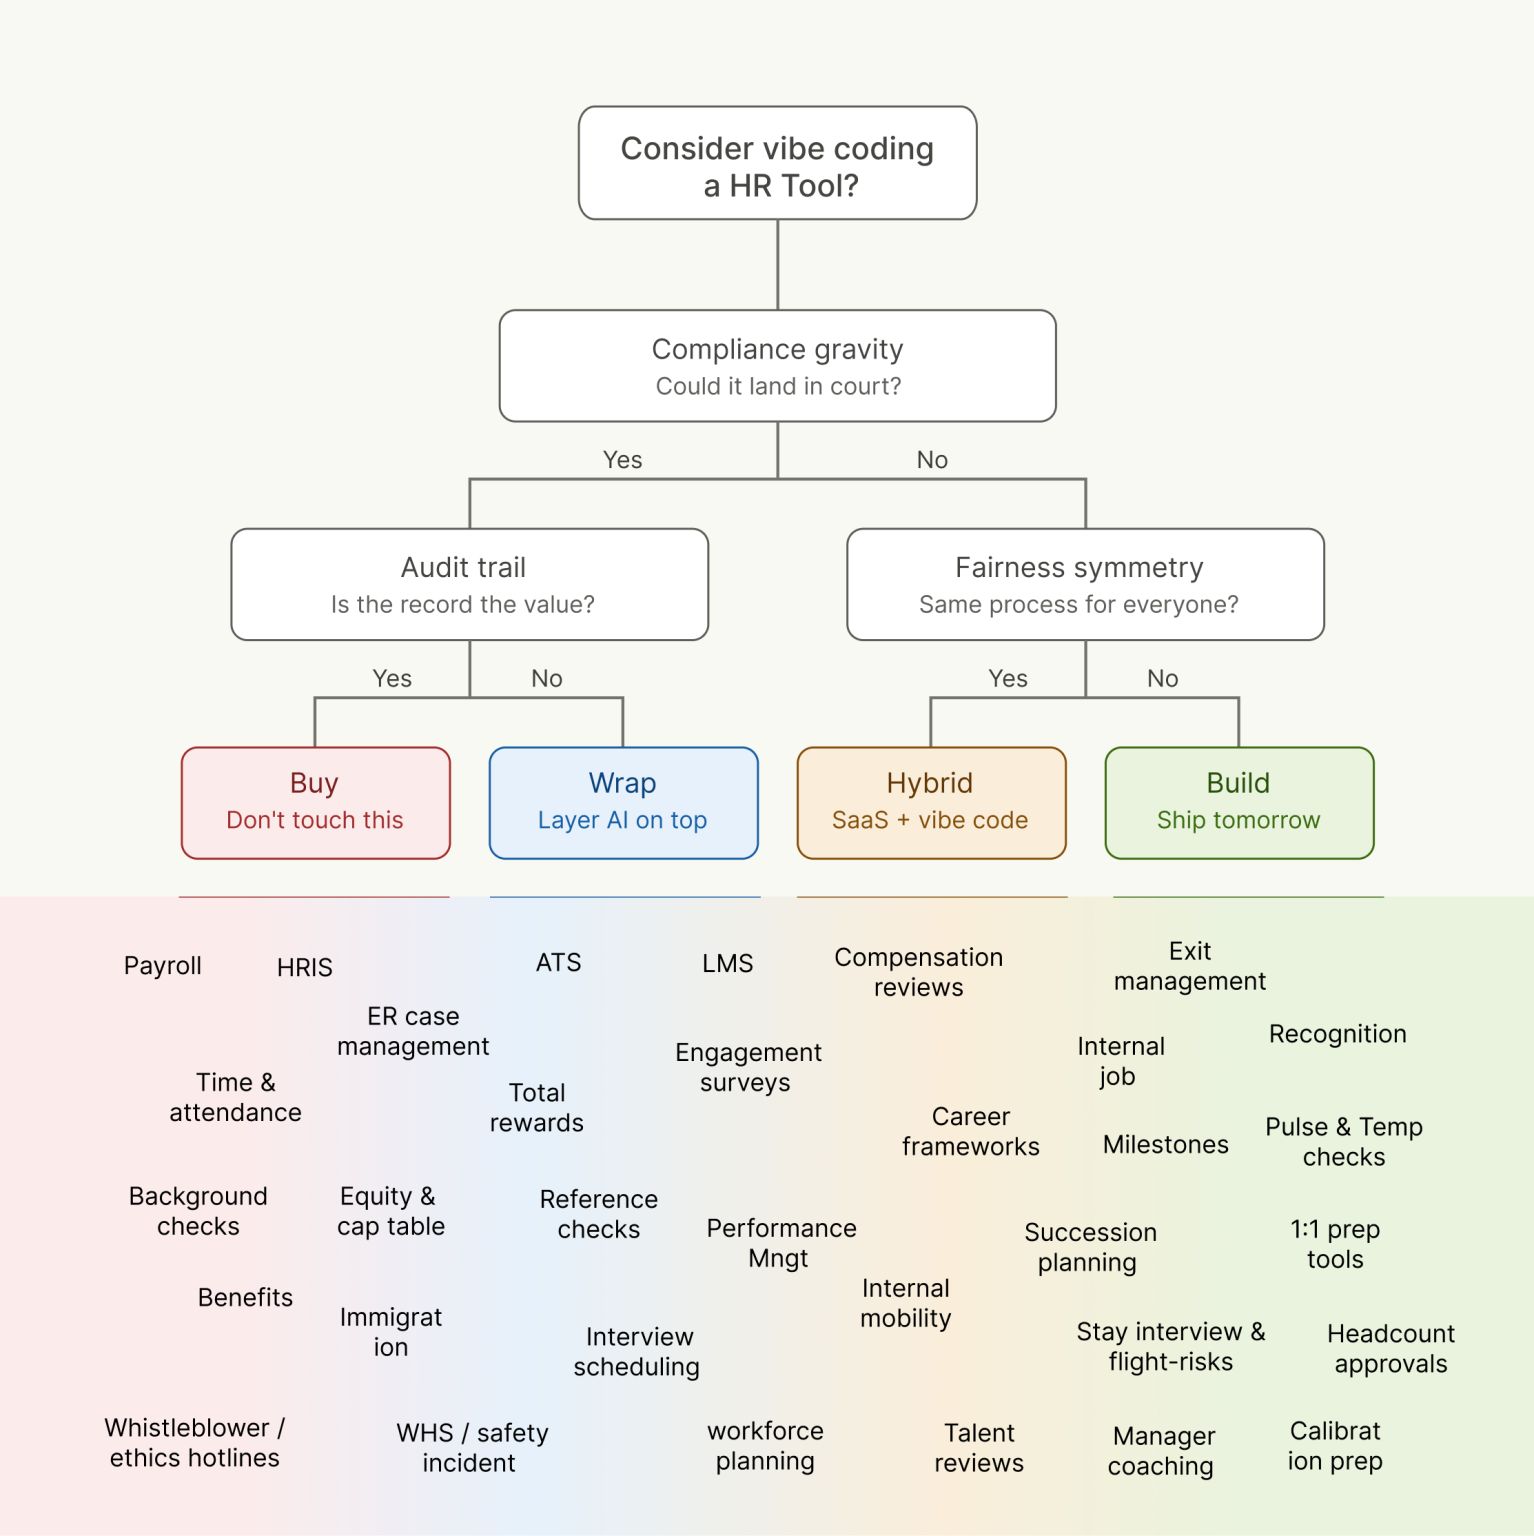
Twee vragen, vier antwoorden: Buy, Wrap, Hybrid of Build.
Twee vragen bepalen alles.
Eerst het gewicht van compliance. Kan dit bij de rechter belanden?
Als dat kan, stel dan nog één vraag. Is het dossier zelf de waarde? Zo ja, dan is het Buy: kopen. Salarisadministratie, HRIS, tijd- en aanwezigheidsregistratie, antecedentenonderzoek, arbeidsvoorwaarden, meldpunten voor klokkenluiders en ethiek. De waarde van deze tools is dat het dossier compleet en verdedigbaar is, en de aansprakelijkheid van iemand anders. Kopen is hier geen bangigheid. Het is weigeren een aansprakelijkheid op je te nemen waar je niets mee wint.
Als compliance echt gewicht heeft, maar het dossier niet de hele kern is, dan is het Wrap: eromheen bouwen. Leg je eigen AI over een systeem dat het risico eronder draagt. Casemanagement voor arbeidsverhoudingen, total rewards, aandelen en de cap table, immigratie, veiligheidsincidenten, ATS, referentiechecks. Je krijgt de workflow die je wilt, zonder eigenaar te zijn van het gevaarlijke deel. Bij Wrap onderschatten de meeste teams zichzelf. In dit vak valt veel te bouwen.
Als het niet bij de rechter kan belanden, stel dan een andere vraag. Is het proces voor iedereen hetzelfde?
Dit is de onderschatte vraag, en ze is typisch HR. Symmetrie in eerlijkheid. Als een tool voor elke persoon hetzelfde proces doorloopt, blijft het risico laag. Zodra de tool onderscheid tussen mensen gaat maken en bepaalt wie wat krijgt, ben je op het terrein van vooroordelen en verdedigbaarheid beland, en staat er ineens veel meer op het spel.
Hetzelfde proces voor iedereen, en je kiest Hybrid. SaaS plus vibe code. Beloningsrondes, engagement-enquêtes, loopbaanraamwerken, performance management, interne mobiliteit, opvolgingsplanning, talent reviews. Houd het dossier in een systeem dat je vertrouwt, en bouw het ritueel en de ervaring eromheen zelf.
Bewust verschillend, weinig compliancegewicht, en je kiest Build: bouwen. Morgen live. Erkenning, pulse- en temperatuurchecks, tools om 1:1's voor te bereiden, mijlpalen, coaching voor managers, stay interviews, exitmanagement. Dit is het hart van vibe coding.
Let op wat "Build" hier betekent. Niet belangrijk of onbelangrijk. Het betekent weinig compliancegewicht en een proces dat iedereen hetzelfde behandelt. Die veilige zone is groter dan de meeste HR-teams denken, en in drie van de vier vakken bouw je iets.
Zes gewoonten waarmee je met gevoelige data kunt bouwen
Ik postte hier iets over, en Aubrey Blanche stelde de scherpste vraag die ik over het onderwerp heb gekregen. Vrij weergegeven: vibe-code je alleen de delen van de stack zonder gevoelige data, en hoe ga je om met de ethische en juridische eisen die horen bij het soort persoonsgegevens waar HR elke dag mee werkt?
Een terechte vraag, en ze verdient een goed antwoord, omdat ze blootlegt wat de meeste gidsen hierover fout doen. Die behandelen gevoelige data als een harde grens. Het is een eis aan je werkwijze. De teams die dit goed doen, zijn niet dapperder dan de rest. Ze hebben hun datastromen zo ingericht dat risico zich om te beginnen niet opstapelt.
Wat ik zie bij bedrijven die dit al verstandig doen:
→ Niemand vindt compliance opnieuw uit. De data staat op een database die al is doorgelicht. Pyn, Supabase, Airtable Enterprise, je bestaande warehouse. Je erft de compliance daarvan, in plaats van eigen infrastructuur voor gevoelige data op te tuigen. Dit is veruit de belangrijkste. De meeste horrorverhalen beginnen met iemand die zelf opslag neerzet.
→ Meedogenloze dataminimalisatie. Verzamel alleen wat de tool echt nodig heeft. De meeste HR-tools worden zo gebouwd dat ze alles verzamelen wat beschikbaar is, omdat het er is. Een tool voor sentiment heeft een score en een team nodig, geen naam en geen rapportagelijn.
→ Echte transparantie tegenover medewerkers. Ze vertellen mensen wat er wordt verzameld, waarom en waar het staat. Goed gedaan is dat beter dan de gemiddelde SaaS-app, waarvan niemand ooit de verwerkersovereenkomst heeft gelezen.
→ Legal en IT vroeg erbij, niet aan het einde. De meeste bedrijven hebben hier al een checklist voor. Neem die en zet hem meteen in je CLAUDE.md, zodat hij elke build vanaf de eerste prompt stuurt, in plaats van aan het einde als veto binnen te komen.
→ Standaard bewaartermijnen. Verwijder sentimentdata automatisch na een kwartaal. Data die je niet meer hebt, kun je niet lekken.
→ Geen persoonsgegevens door LLM-API's. Dit is de echte harde grens, en die is veel smaller dan "houd gevoelige data weg bij AI".
Doe die zes dingen, en je kunt aanzienlijk meer bouwen dan de voorzichtige versie van dit advies doet vermoeden. Sla ze over, en je kunt beter bij SaaS blijven.
Vibe coding betekent niet dat je roekeloos te werk gaat. De discipline is de toegangsprijs, en die prijs is veel lager dan de meeste HR-teams denken.
Praktijkcase: een tool voor beoordelingen bouwen en neerzetten
Theorie is makkelijk. Stel dat je iets lastigers wilt bouwen: een tool voor beoordelingen, om maar iets te noemen, omdat het de vraag is die ik het vaakst hoor en omdat die precies op de interessante rand zit.
Baken het eerst eerlijk af.
Een beoordelingstool is een Hybrid (zie de test). Het proces is voor iedereen hetzelfde, wat het risico beperkt, maar compliance weegt echt, omdat beoordelingen doorwerken in beslissingen over salaris en ontslag en in geschillen worden betrokken. Bepaal dus wat je tool mag beheren voordat je een prompt schrijft. Je kunt de cyclus bouwen, de seintjes, de voorbereiding voor managers, de conceptnotities, het bijhouden van wat is afgerond? Maar voor de eindbeoordelingen, de uitkomsten van kalibratie, alles wat wordt aangehaald als iemand wordt ontslagen, heb je nog steeds een audit trail nodig. (als het systeem een dossier is voor beslissingen over beloning of prestaties, valt het onder juridische discovery)
Daarna moet het ergens kunnen staan.
Wat volgt is de stack die ik gebruik. Let op: voor elk onderdeel zijn er goede alternatieven. Cursor in plaats van Claude Code, Neon of Airtable in plaats van Supabase, Vercel of Render in plaats van Railway, GitLab in plaats van GitHub. Ik beweer niet dat dit objectief de juiste keuzes zijn. Het zijn de tools waarmee ik heb gebouwd, ze werken goed samen en ze zijn vergevingsgezind als je nog leert. Vervang ze gerust door iets wat je al kent.
De tools, en waarom elk ervan erbij zit
✍️ Claude Code bouwt het. Niet het chatvenster. Deze versie werkt door je hele project heen, voert opdrachten uit en volgt de regels die je één keer opschrijft in een bestand dat CLAUDE.md heet, zodat je dataclassificatie en je juridische kaders voor elke prompt gelden, in plaats van alleen voor de prompts waarbij je eraan denkt. (Je bestaande abonnement.)
↳ Het addertje: CLAUDE.md is een richtlijn, geen handhaving. Het model kan het negeren, en er is geen audit trail die bewijst dat het dat niet deed.
🗄️ SUPABASE is waar de data staat. Zie het als de archiefkast, plus het slot. Het regelt de logins, en dat is code die je nooit door een AI moet laten improviseren. En het dwingt op databaseniveau af wie wat mag zien, zodat "een manager ziet alleen de beoordelingen van het eigen team" een regel is die de database zelf bewaakt, in plaats van een regel die je app op elke plek waar die data ophaalt correct moet onthouden. Dat verschil is waar het bij medewerkersdata om draait. ($25/maand. Zie de opmerking hieronder over het abonnement van $599.)
↳ Het addertje: row-level security staat standaard uit. Eén onbeschermde tabel en iedereen leest de beoordelingen van iedereen. Policy's moeten ook per rol worden getest, en bijna niemand test de negatieve gevallen, terwijl die er juist toe doen.
🪪 GOOGLE LOGIN bewijst wie iemand is. Als je Google Workspace gebruikt, heb je al een directory die van iedereen de naam, de manager en de afdeling kent. Door die te koppelen hoeft niemand nog een wachtwoord aan te maken, en als IT op de laatste werkdag iemands account uitschakelt, verliest die automatisch de toegang tot je tool. (Gratis, inbegrepen in Workspace.)
↳ Het addertje: je moet het beperken tot je Workspace-domein. Laat je dat open, dan kan elk Google-account ter wereld inloggen.
⏰ RAILWAY laat het draaien. Een plek waar de app echt op internet staat, en vooral: een plek om dingen volgens een schema te laten lopen. De cyclus opent op maandag, herinneringen gaan op donderdag de deur uit, de achterblijvers krijgen een week later een seintje. De meeste HR-rituelen zijn ingepland werk, en daarom is dit belangrijk. (Ongeveer $5 tot $20/maand.)
↳ Het addertje: ingeplande jobs kunnen dubbel afgaan of overslaan zonder dat je het merkt.
↩️ GITHUB is je knop om iets ongedaan te maken. Elke versie van de tool wordt bewaard, dus als de AI vol overtuiging iets stukmaakt wat gisteren nog werkte, ga je terug. Niet onderhandelbaar, en gratis. (Gratis.)
↳ Het addertje: het is alleen een knop om iets ongedaan te maken als je commits schoon en frequent zijn. En code terugdraaien maakt databasemigraties niet ongedaan en brengt verwijderde data niet terug.
💬 SLACK (TEAMS) is hoe mensen het echt gebruiken. Het gebruik sterft uit als medewerkers moeten onthouden dat er een portal bestaat. Het seintje moet aankomen waar ze al zijn. (Gratis te bouwen in je eigen workspace.)
↳ Het addertje: DM's van een bot over prestaties voelen als toezicht. En te veel meldingen maken het ritueel toch kapot, dus ga zuinig om met je seintjes.
🚨 SENTRY vertelt je wanneer het stukgaat. Zonder hoor je het van een medewerker, en dat is voor een HR-tool de omgekeerde wereld. (Het gratis abonnement volstaat.)
↳ Het addertje: foutmeldingen leggen standaard persoonsgegevens en beoordelingstekst vast. Je moet scrubbing hebben ingesteld en een verwerkersovereenkomst hebben voordat het echte data aanraakt.
✉️ RESEND verstuurt e-mail, voor de momenten waarop Slack niet genoeg is. Optioneel als je alleen via Slack seintjes geeft. (Gratis tot 3.000 e-mails per maand.)
↳ Het addertje: SPF, DKIM en DMARC moeten op je domein zijn ingesteld. Sla je dat over, dan belandt je mail in de spam of word je aangemerkt als iemand die het eigen bedrijf spooft :
🔑 ANTHROPIC API KEY, alleen als de tool zelf AI aanroept terwijl die draait, bijvoorbeeld om de notities van een manager samen te vatten. Goed om te weten: dit wordt apart gefactureerd van je Claude-abonnement, dat dekt dat jij code schrijft, niet dat je app aanroepen doet. Teams komen hier pas achter nadat ze live zijn gegaan. ($5 tot $50/maand, afhankelijk van het gebruik.)
↳ Het addertje: geen uitgavenlimiet betekent een verrassing op de factuur. Een loop kan het budget er snel doorheen jagen.
🌐 DOMEINNAAM geeft de tool een adres dat mensen vertrouwen. Een interne tool op een net subdomein van de site van je bedrijf wordt gebruikt. Dezelfde tool op een willekeurige reeks tekens wordt genegeerd, of erger, gemeld als poging tot phishing. (Ongeveer $15/jaar, of gratis op een subdomein dat je al hebt.)
↳ Het addertje: je hebt IT en controle over DNS nodig.
🔍 EEN TECHNISCHE REVIEW Geen tool, uiteraard. Maar tenzij je de capaciteit in huis hebt, reserveer je budget voor iemand met technische kennis die de toegangsregels en de loginflow controleert voordat er echte medewerkersdata in de buurt komt. Niet om het te bouwen. Om het te controleren. (Een halve dag van een freelancer, eenmalig $500 tot $1,500.)
↳ Het addertje: een eenmalige review is verouderd bij de volgende wijziging die AI genereert.
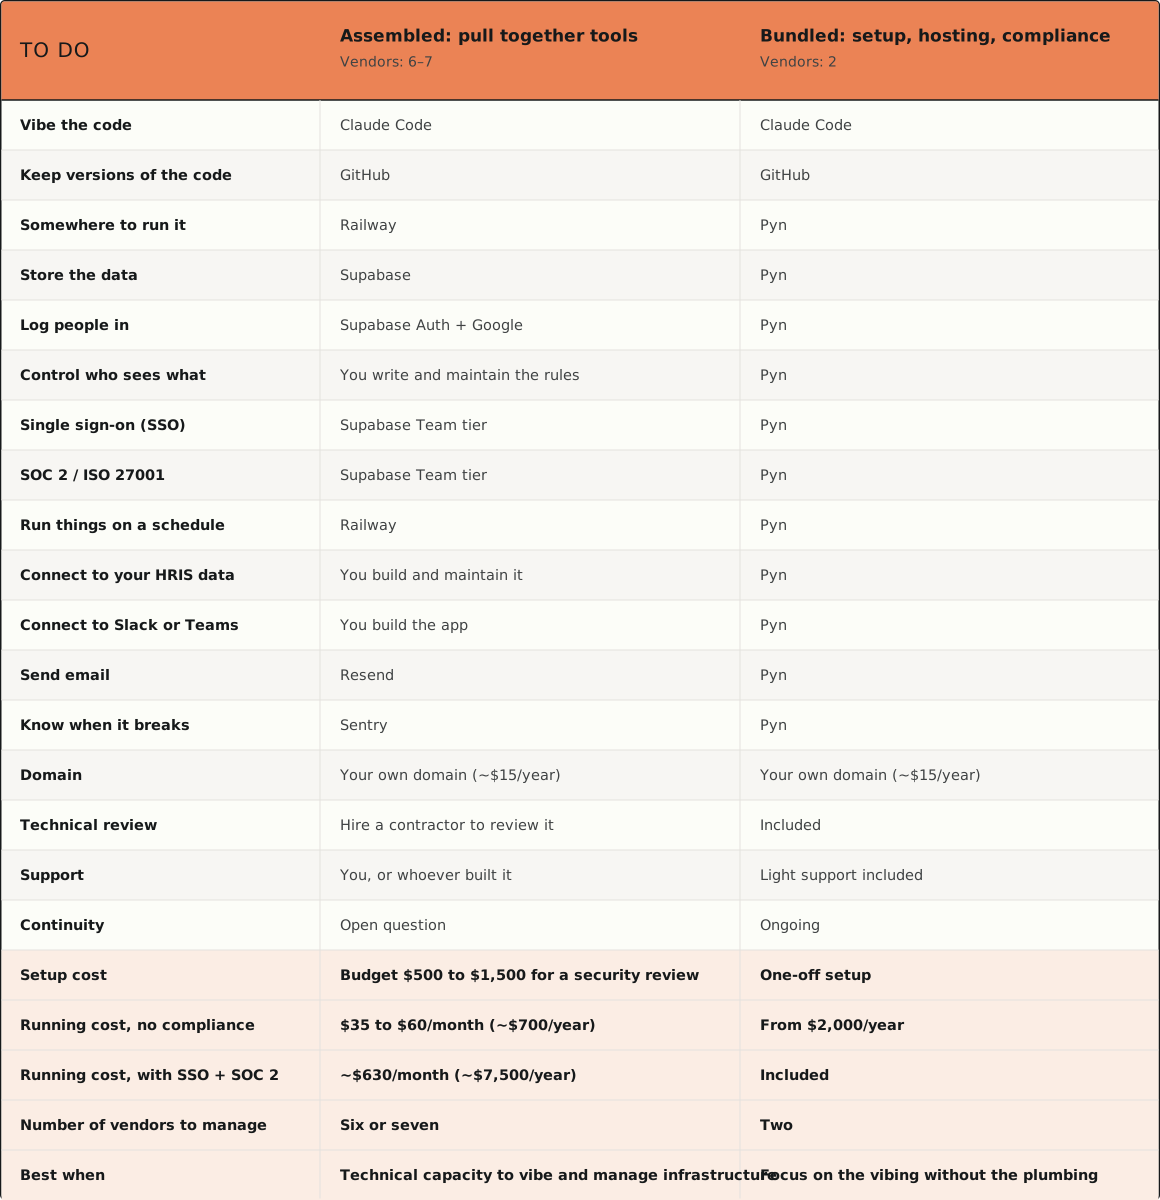
Alle tooling bij elkaar: ruwweg $35 tot $60 per maand, tot $660 als je single sign-on en SOC 2 nodig hebt. En een eenmalige technische review van $500 tot $1,500. Wat in dit budget ontbreekt, zijn de kosten van doorlopend onderhoud, bereikbaarheid bij storingen en de vraag wie eigenaar is als de bouwer vertrekt.
📦 OF GEBRUIK PYN, als je het liever niet zelf in elkaar zet. Wil je iets wat meer een geheel is, dan vervangt Pyn Supabase, Google login, Railway, Resend, de Slack- of Teams-app en Sentry, en regelt het die voor je. Inrichting, testen en lichte support zijn inbegrepen, net als single sign-on en SOC 2. De tool schrijf je nog steeds zelf. (Meer over de kosten hieronder.)
De vraag van $25 of $599
Supabase heeft een abonnement van $25 en een van $599, en het gat daartussen is het belangrijkste getal van dit hele hoofdstuk. Voor $25 krijg je de database, de logins en de toegangscontrole per rij. Dat is ruim genoeg voor rituele tools en de meeste tools met gevoelige maar afgebakende data.
Voor $599 krijg je single sign-on, een SOC 2-verklaring, ISO 27001, audit logging en langere bewaring van back-ups. Dat is het abonnement dat je nodig hebt als je eigen securityteam om bewijs vraagt, als de tool echt gevoelige medewerkersdata bevat, of als een belofte niet meer genoeg is en iemand het certificaat wil zien. Naast $25 klinkt het als veel. Het is een fractie van wat het kost om dat niveau zelf op te bouwen, en aanzienlijk minder dan de meeste HR-SaaS.
Maar eerlijk is eerlijk: bij dingen als SOC2 komt nog een hoop werk kijken dat hier niet is meegenomen. Upgraden maakt de tool vooral robuuster. Voor echte compliance laat je Pyn hosten.
De trigger is eenvoudig. Op het moment dat iemand bij Legal of IT vraagt "is dit SOC 2", zit je op het abonnement van $599, en had je daar al moeten zitten.
Gebundelde aanpak: richt je op het vibe-coden, zonder het leidingwerk
Alles hierboven gaat ervan uit dat je het leidingwerk zelf wilt beheren. Veel teams willen dat niet.
Het alternatief is deze tools op Pyn te hosten. Je vibe-codet het nog steeds zelf, het blijft jouw tool, maar Pyn regelt de delen die je liever niet leert: logins en toegangscontrole, de database, de inrichting, de koppeling met je HRIS en Slack, single sign-on, SOC 2, testen voordat het live gaat, en lichte support als er op een ongelegen moment iets stukgaat. $9,000 voor de inrichting, daarna $2,000 per jaar.
Of dat het waard is, hangt af van één vraag. Heb je iemand die eigenaar kan zijn van authenticatie, toegangsbeleid, uptime en integraties, en die er over anderhalf jaar nog is? Zo ja, zet het dan zelf in elkaar. Het is goedkoper en je leert er meer van. Als die persoon eigenlijk "wie er tijd heeft" is, gaat het bij het onderhoud mis, en is iemand betalen om dat te dragen de betere ruil.
Naast elkaar
Dezelfde tool, dezelfde code, twee manieren om hem neer te zetten. In de linkerkolom zet jij alles in elkaar. In de rechter bouw je het nog steeds zelf, en is het leidingwerk geregeld.
Wat je nodig hebt om een interne HR-tool neer te zetten
Bouwtijd versus runtime: wanneer medewerkersdata echt risico loopt
Dit is het punt dat het bezwaar wegneemt dat ik het vaakst hoor. "We kunnen geen AI gebruiken om onze tools te bouwen, want we mogen er geen medewerkersdata naartoe sturen."
Je haalt twee verschillende beslissingen door elkaar.
Bouwtijd. Als je een tool bouwt, stuur je code naar het model, geen medewerkersdossiers. Je ontwikkelt met synthetische data. De cloud is prima. Er komt niets gevoeligs in de buurt van de AI.
Runtime. De vraag over data komt later, als een live agent echte medewerkersdossiers gaat lezen om zijn werk te doen. Daar doen dataresidentie, on-prem modellen en toegangscontrole er echt toe.
Ik heb deze grens leren trekken toen ik een demo voor het automatiseren van offboarding bouwde. Ik liet die draaien op synthetische BambooHR-data, niet omdat het bouwen riskant was, maar omdat een live agent die echte dossiers leest de echte beperking was. Bouwen en draaien zijn twee verschillende kamers. Laat een angst uit de bouwtijd je niet tegenhouden, en laat een risico uit de runtime er niet doorheen glippen omdat je jezelf hebt wijsgemaakt dat "het maar AI is die code schrijft".
De heldere manier om het vast te houden: "is het veilig om dit met AI te bouwen" is bijna altijd ja. "Is het veilig om dit los te laten op echte data" is de vraag die je aandacht verdient, en die heeft een goed antwoord zodra je de zes dingen hierboven hebt gedaan.
Kosten: wanneer je gewone automatisering gebruikt in plaats van AI
AI is echt geweldig. Het is ook probabilistisch, duur per run en lastig te volgen. De discipline is dus saai. Los eerst zo veel mogelijk op met gewone automatisering, en bewaar AI voor de delen die echt een oordeel of taal nodig hebben.
Een workflow op basis van regels, van het onopvallende soort zoals Zapier, n8n of Pyn, is goedkoop, voorspelbaar en makkelijk te debuggen. Als hij stukgaat, gaat hij elke keer op dezelfde manier stuk. Een AI-agent is geen van die dingen. Hij kost meer bij elke keer dat hij afgaat, hij kan op dinsdag iets net anders doen dan op maandag, en uitzoeken waarom is echt werk.
Het getal dat me bijbleef: Uber zou zijn hele jaarbudget voor AI er in ongeveer vier maanden doorheen hebben gejaagd. Probabilistische tools hebben er een handje van om de rekening te laten oplopen terwijl je de andere kant op kijkt.
De kostenvraag is dus niet "AI of niet". Het is "wat is het eenvoudigste mechanisme dat dit werk doet". Als een automatisering de herinnering kan sturen, het verzoek kan doorzetten of het veld kan bijwerken, gebruik die dan. Bewaar de dure, onvoorspelbare tool die oordelen velt voor waar die zijn plek verdient. Automatisering is saai en goedkoop. Precies daarom grijp je er het eerst naar.
Zicht: wat je bijhoudt zodra er meerdere tools draaien
De valkuil is eenvoudig. Je vibe-codet één tool. Dan vijf. Dan gaan er dertig automations af in je organisatie en ben je de draad kwijt. Je ziet niet wat er draait, wie het bereikt of of iets ervan werkt.
Gefeliciteerd. Je hebt shadow IT opnieuw gebouwd. Alleen staat jouw logo er nu op.
De oplossing is het zicht er vanaf het begin in te bouwen. Drie dingen die elke tool moet laten zien:
→ Wie wat meemaakt. Welke medewerkers en managers het ding echt ontvangen, zien en gebruiken.
→ Wat er afgaat. Welke AI-aanroepen en automations draaien, wanneer en hoe vaak.
→ Uitkomsten. Geen cijfers voor de bühne. Afronding, leesbereik en niet-naleving, dus wie het had moeten doen en het niet deed.
Die laatste is de onderschatte functie. De meeste HR-tooling kan je vertellen wat er is gebeurd. Heel weinig kan je vertellen wie niet deed wat verplicht was. Nu AI in HR steeds meer wordt gedocumenteerd en gelogd, verandert het vermogen om dat te beantwoorden snel van een leuk dashboard in een audit trail waarvan je blij bent dat je hem hebt bewaard.
Bepaal voordat je een tool live zet hoe je gaat zien dat hij werkt. Als je "wie heeft dit meegemaakt, en wat gebeurde er" niet kunt beantwoorden, ben je nog niet klaar met bouwen.
Integratie: data uit de ene tool in de volgende krijgen
Een vibe-coded tool die zijn eigen data oppot, is geen bezit. Het is een eiland, en op eilanden gaat waarde dood.
De sentimentscore, het signaal van erkenning, de beslissing over de reorganisatie, de data over afronding. Het meeste wordt pas waardevol als het stroomt: naar de volgende tool, naar de context van de manager en, waar het thuishoort, naar het bronsysteem. Een tool voor erkenning die je talentproces nooit vertelt wie een team bij elkaar houdt, is leuk speelgoed. Koppel dat signaal aan prestaties en opvolging, en het wordt een hefboom.
Ontwerp elke tool dus vanaf dag één met een afrit. Een export, een API, een webhook. Bepaal bewust wat waarheen stroomt. Wat terug synchroniseert naar het bronsysteem. Wat lokaal blijft en de browser nooit verlaat. Wat het volgende ritueel voedt.
Hier ligt de echte prijs. Je wint niet door eigenaar te zijn van de salarisadministratie. Dat is iemand anders al, en dat moet je niet willen. Je wint door eigenaar te zijn van de contextlaag die over alles heen ligt, het bindweefsel dat weet wie wat meemaakt, zodat elke tool die je bouwt slimmer wordt doordat de andere bestaan.
Vibe-code de rituelen, koop de bronsystemen, en word dan eigenaar van de laag erbovenop.
Onderhoud: wat je zelf kunt repareren, en wat niet
Voor een kleiner bedrijf voelt een SaaS-tool van $500 per maand duur. Een weekend prompts in Claude voelt gratis. Geen van beide klopt.
Het bouwen is 20% van het werk. Onderhoud is de andere 80%. Hosting, authenticatie, logs, audit trails, de integraties die stukgaan als een leverancier een API wijzigt zonder het je te vertellen. Niets ervan is glamoureus. Alles ervan is nodig.
Het goede nieuws is een echt ander perspectief. Het grootste deel van dat onderhoud kun je nu vibe-onderhouden. HR-teams schatten het geheel te zwaar in, omdat ze zich voorstellen dat ze het moeten onderhouden als kwetsbare enterprisesoftware: kostbaar en gevaarlijk om aan te raken. Meestal is het dat niet. Je kunt deze tools repareren, bijstellen en uitbreiden op dezelfde manier waarop je ze hebt gebouwd. Wees niet zo bang voor de code dat je hem niet durft te veranderen.
Het echte tegenwicht: sommige dingen kun je niet vibe-onderhouden. Authenticatie, de omgang met persoonsgegevens, echte integraties, audit logging. Zodra een tool dat terrein op gaat, is "ik prompt wel even een oplossing" niet meer goed genoeg. Weten in welke categorie je zit, is de echte vaardigheid, en door de inrichting van je database te erven, is het grootste deel van die last van je bord voordat die begint.
En stel de onglamoureuze vraag vroeg. Wie is hier eigenaar van als Sarah vertrekt? Een tool die in het hoofd van één persoon leeft, is een kwetsbaarheid, geen prestatie.
Beveiliging: hoeveel zorgvuldigheid elk soort tool nodig heeft
Het enge cijfer is echt. De scan van één securitybedrijf van duizenden vibe-coded apps die live staan, vond dat ruwweg een op de drie een ernstig, uit te buiten lek had. Onderzoek na onderzoek laat zien dat code die AI genereert duidelijk meer beveiligingsfouten bevat dan code die mensen schrijven. Gelekte secrets, injectielekken, kapotte toegangscontrole.
Lees dat niet als een reden om te stoppen met bouwen. Lees het als de omvang van de schade als het misgaat. Een SQL-injectielek in een muur met complimenten lekt kudos. Hetzelfde lek in een beloningstool lekt salarissen. Dezelfde fout, een totaal ander gevolg. Stem je zorgvuldigheid af op je datalaag. Daarom heb je de data eerst geclassificeerd, en daarom is het erven van een doorgelichte database zo belangrijk. Een flink deel van die mislukkingen van een op de drie is infrastructuur die de bouwer nooit zelf had moeten neerzetten.
Twee dingen om goed te onthouden:
"Het werkt" en "het is veilig" voelen hetzelfde, en zijn het niet. Code die AI genereert kan er volkomen correct uitzien en toch een kritiek lek verbergen. Het draait, dus het lijkt goed, en de kwetsbaarheid blijft onzichtbaar tot er iets stukgaat. Voor een bouwer zonder technische achtergrond is dat de hele valkuil.
Client-side is een echte keuze voor privacy, met echte grenzen. Verschillende van mijn tools zijn zuivere client-side apps. Geen backend, niets verlaat je browser, dus er ligt geen stapel medewerkersdata op een server. Echt veiliger dan gewone SaaS voor data onderweg en voor risico bij derden. Maar het is de inrichting van een persoonlijk kladblok, niet die van een bronsysteem. Opslag in de browser is in rust niet versleuteld, er is geen toegangscontrole, geen audit log. Perfect om een reorganisatie te modelleren. Niet de plek voor iets wat je niet kunt missen.
Als een tool het verdient om een datalaag op te schuiven, doe dat dan niet op gevoel. Haal er een technische partner bij, een fractional CTO of een ontwikkelbureau, om door te lichten wat dragend is en wat kwetsbaar. Laat hem dan bewust doorgroeien, van client-side naar gehost op echte infrastructuur, met degelijke authenticatie, tenancy, versleuteling, audit logging en toegang op basis van rollen. Dat is het verschil tussen een weekendproject en iets wat duizend mensen veilig kunnen gebruiken.
Acht vragen om te stellen voordat je bouwt
Als je niet de hele boom wilt doorlopen, haal de tool dan door deze acht. Het zijn de vragen van die eerste kaart, in de volgorde waarin ik ze echt stel:
- Kan het een week uitvallen zonder gevolgen?
- Als het nu stukging, zou je dan naar AI grijpen, of naar de telefoon?
- Kan een collega het in een week oppakken en onderhouden?
- Hoeveel mensen zijn ervan afhankelijk?
- Is de data gevoelig of gereguleerd, en zo ja, op wiens infrastructuur staat die?
- Hoe snel kun je het door SaaS vervangen als het ermee ophoudt?
- Heb je over 12 maanden audit logs of compliancedocumenten nodig?
- Hoeveel integraties heeft het nodig?
Vraag vijf is de vraag die het meest verschuift. Gevoelige data op infrastructuur die je zelf hebt neergezet, is een reden om te stoppen. Dezelfde data in een database waarvan de compliance al op orde is, is een reden om door te gaan.
Vijf gratis tools die ik ter inspiratie heb gebouwd
Genoeg theorie. Vijf tools die ik de afgelopen weken heb gevibe-coded. Elk ervan is een ritueel. Geen ervan is een bronsysteem. Dat is geen toeval. Het is het hele punt.
Doe ermee wat je wilt. Zie ze als inspiratie, als iets om gewoon over te nemen, of sla het weekend over en gebruik ze. Ze zijn gratis.
🔄 (re)org → organogrammen en scenario's voor een reorganisatie modelleren. Sleep mensen rond, markeer vertrekkers en rollen zonder naam, leg scenario's naast elkaar en zie de verschillen in beloning live meebewegen. Draait volledig client-side, dus niets verlaat je browser. De juiste inrichting voor een gevoelig concept van een reorganisatie.
🦘 Dollaroo → erkenning tussen collega's. Kudos op de plek waar het werk gebeurt, in Slack. Het soort ritueel waarbij weinig op het spel staat en dat veel warmte geeft, dat geen leverancier goed bouwt en dat iedereen wil. (De echte prijs ligt verderop. Koppel dat signaal van erkenning aan je denken over talent en opvolging, en je leert wie teams bij elkaar houdt.)
🌡️ Team Temperature → wekelijks sentiment. Met één tik een beeld van hoe teams er echt voor staan. De peiling is niet het punt. Het zicht wel: een doorlopend signaal over wie wat meemaakt, voordat het opduikt in een exitgesprek.
📉 Drift → kwartaalcheck op prestaties. Ja, "prestaties" klinkt als iets voor de kolom Buy. Maar Drift is niet het systeem dat over beoordelingen of beloning beslist. Het is het ritueel dat opmerkt. Mensen vallen zelden van een klif. Ze drijven af, kwartaal na kwartaal. Een volledige beoordelingscyclus verdeelt de aandacht gelijk over iedereen, ook over de mensen met wie het al goed gaat. Drift legt de focus op het handjevol gevallen dat de prestaties van het team echt beïnvloedt, zodat je het opmerkt voordat iemand verrast is. Het ritueel, niet het dossier.
🌱 Grow → raamwerken voor loopbaangroei. Loopbaanraamwerken zonder de consultant of het platform van zes cijfers. Het is ook de helderste illustratie van de grens tussen bouwtijd en runtime. Grow is een client-side app, dus medewerkersdata verlaat de browser nooit. De AI heeft me geholpen het te bouwen. Je mensen ziet hij nooit.
Vijf tools, één patroon. Smalle, interne rituelen, elk ontworpen om zijn data door te geven in plaats van op te potten, elk op infrastructuur waarvan de compliance al op orde is. Door dat laatste kostte het bouwen een weekend in plaats van een project.
Waar dit naartoe gaat: de contextlaag
De teams die dit goed doen, zijn niet zuinig op hun code. Ze zijn zuinig op hun datastromen, en op waar de informatie van hun medewerkers terechtkomt.
Dat is wat je moet meenemen. De beperking op hoeveel HR kan bouwen is niet de gevoeligheid van de data die je hebt. Het is of je de zes onglamoureuze dingen hebt gedaan die voorkomen dat risico zich opstapelt. Erf compliance in plaats van die zelf op te bouwen. Verzamel minder. Vertel mensen wat je verzamelt. Haal Legal en IT erbij bij de eerste prompt. Verwijder volgens een schema. Houd persoonsgegevens uit LLM-API's.
Doe dat, vibe-code dan de rituelen, koop de bronsystemen en bouw de contextlaag erbovenop, die het geheel meer waard maakt dan de som der delen.
De meeste HR-teams spelen dit veel veiliger dan nodig is.
Waar zou jij de grens trekken?